(2/3 + 1/4) × 3/5 işlemi, internetten katılan 354 Amerikalı yetişkinin önüne aynı deneyde iki kez geldi. İlk seferinde katılımcıların yarısından fazlasının ekranının kenarında bir sohbet penceresi açıktı. Katılımcılara ChatGPT diye tanıtılan, GPT-5 ile çalışan bu bot soruyu da çözümünü de önceden biliyordu; "cevap?" yazmak yetiyordu. Birkaç dakika sonra aynı işlem testin ilk sorusu olarak yeniden çıktı. Bu kez pencere yoktu ve kapanacağını kimse önceden söylememişti.1
Pencere kapanınca botla çalışanlar daha az soru çözdü, daha çok soruyu boş geçti. Ekip sonucu iki deneyle daha sınadı ve toplam 1.222 kişiye ulaştı.12
- Deneyde "pes etmek" nasıl ölçüldü ve botu kapatmak neden habersiz yapıldı?
- Kesirde görülen düşüş, okuduğunu anlama sorularında da tekrarladı mı?
- Botla çalışan herkes aynı yerde mi bitirdi, yoksa soruyu nasıl sorduğun sonucu değiştirdi mi?
- On beş dakikalık bir deney aylarca süren kullanım hakkında ne söyleyebilir, ne söyleyemez?
Deney nasıl kuruldu
Çalışmanın ilk yazarı Carnegie Mellon Üniversitesi'nden Grace Liu. Yanında Oxford'dan Brian Christian ve Tsvetomira Dumbalska, MIT'den Michiel Bakker, UCLA'dan Rachit Dubey var. Christian aynı zamanda Berkeley'deki İnsanla Uyumlu Yapay Zekâ Merkezi'nde araştırmacı ve hizalama sorunu üzerine yazdığı 2020 tarihli kitabıyla tanınıyor. Makalenin ilk sürümü 6 Nisan 2026'da arXiv'e yüklendi; hakemden geçen son hali Ekim 2026'nın ilk haftasında Dil Modelleme Konferansı'nda (COLM) sunuldu.12
Katılımcılar Prolific adlı çevrim içi araştırma platformundan toplandı. İlk deney 13 dakika sürdü ve kişi başı 2,60 dolar ödendi. Herkese ödemenin doğru cevap sayısına bağlı olmadığı, yanlış cevabın ceza getirmediği açıkça söylendi. Yanlış cevap verenin ekranında doğru çözüm hemen gösteriliyordu, yani iki grup da hatasından öğrenebiliyordu. Her sorunun altında bir "geç" düğmesi vardı. Ceza olmayan bir oyunda bu düğmeye basmak, yapamadığın için değil uğraşmak istemediğin için verilen bir karar sayılıyor. Ekip sebatı bu düğmeyle ölçtü.1
Bot grubunun önüne zorlaşan 12 soru kondu; bot kapandıktan sonra iki grup aynı 3 soruyla sınandı.
Üç deneyde aynı yön
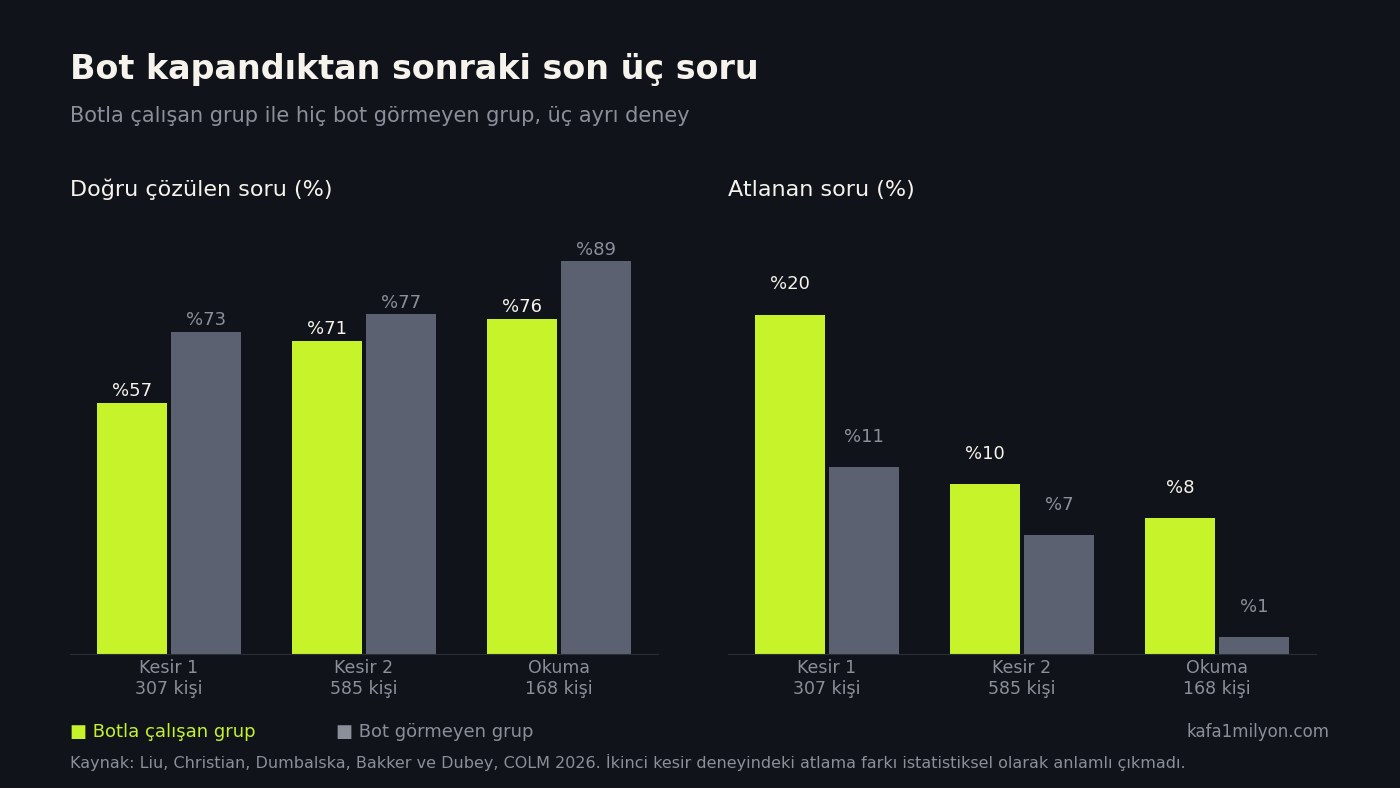
İlk deneyde analize giren 307 kişiden botla çalışanlar son üç sorunun yüzde 57'sini doğru çözdü, botu hiç görmeyenler yüzde 73'ünü. Atlama oranı yüzde 20'ye karşı yüzde 11 çıktı.1
Bu ilk sonuçta bir açık vardı. Ekip temel kesir işlemini beceremeyenleri analizden çıkarmıştı ama bot grubunda aynı kişiler doğru cevabı bottan alıp elemeden kurtulabiliyordu. İkinci deney bu yüzden 667 kişiyle ve bir ön testle kuruldu: herkes önce yardımsız 3 kolay soru çözdü, eleme buna göre yapıldı. Kontrol grubunun ekranına da ön testin çözümlerini gösteren bir kenar paneli kondu ve test başlarken o da kaldırıldı. Böylece iki grup da test anında ekranından bir şeyin kaybolduğunu yaşadı. Fark küçüldü ama kaybolmadı: 585 kişide doğru çözme yüzde 71'e karşı yüzde 77 oldu. Atlamada yüzde 10'a karşı yüzde 7 görüldü, bu fark istatistiksel olarak anlamlı çıkmadı.1
Üçüncü deney kesirden çıkıp ABD'deki üniversite sınavı SAT'ın okuduğunu anlama sorularına geçti. 5 soruluk çalışmanın ardından bot kapandı. Metni okumaya yetmeyecek kadar kısa sürede, 5 saniyenin altında verilen cevap da atlanmış sayıldı. 168 kişide doğru çözme yüzde 76'ya karşı yüzde 89, atlama yüzde 8'e karşı yüzde 1 çıktı.1
- 1.222
- Üç deneye katılan toplam kişi sayısı; her deney 13 ile 15 dakika sürdü.Liu ve ark., COLM 2026
- %57 / %73
- İlk kesir deneyinde bot kapandıktan sonra son üç sorudaki doğru çözme oranı: botla çalışanlar ve botu hiç görmeyenler.Liu ve ark., COLM 2026
- %61
- İkinci deneyde bot grubundan botu esas olarak cevabı doğrudan almak için kullandığını söyleyenlerin oranı.Liu ve ark., COLM 2026
- %17
- Yeni bir kodlama kütüphanesini yapay zekâ yardımıyla öğrenen yazılımcıların, elle yazanlara göre bilgi sınavında aldığı daha düşük puan.Shen ve Tamkin, Anthropic, 2026
Cevabı isteyenle ipucu isteyen
İkinci deneyin sonunda bot grubuna botu nasıl kullandıkları soruldu. Yüzde 61'i cevabı doğrudan aldığını, yüzde 27'si ipucu ve açıklama istediğini, yüzde 12'si botu hiç kullanmadığını söyledi. Kayıp ilk gruba yığılmıştı. Cevabı doğrudan alanlar testte yüzde 65 çözdü ve yüzde 13 atladı; ipucu isteyenlerde bu sayılar yüzde 76 ve yüzde 5'ti. Cevabı alanlar kendi ön test başarılarının da 10 puan gerisine düştü. Diğer gruplar ön testteki yerinde kaldı ya da biraz ilerledi.1
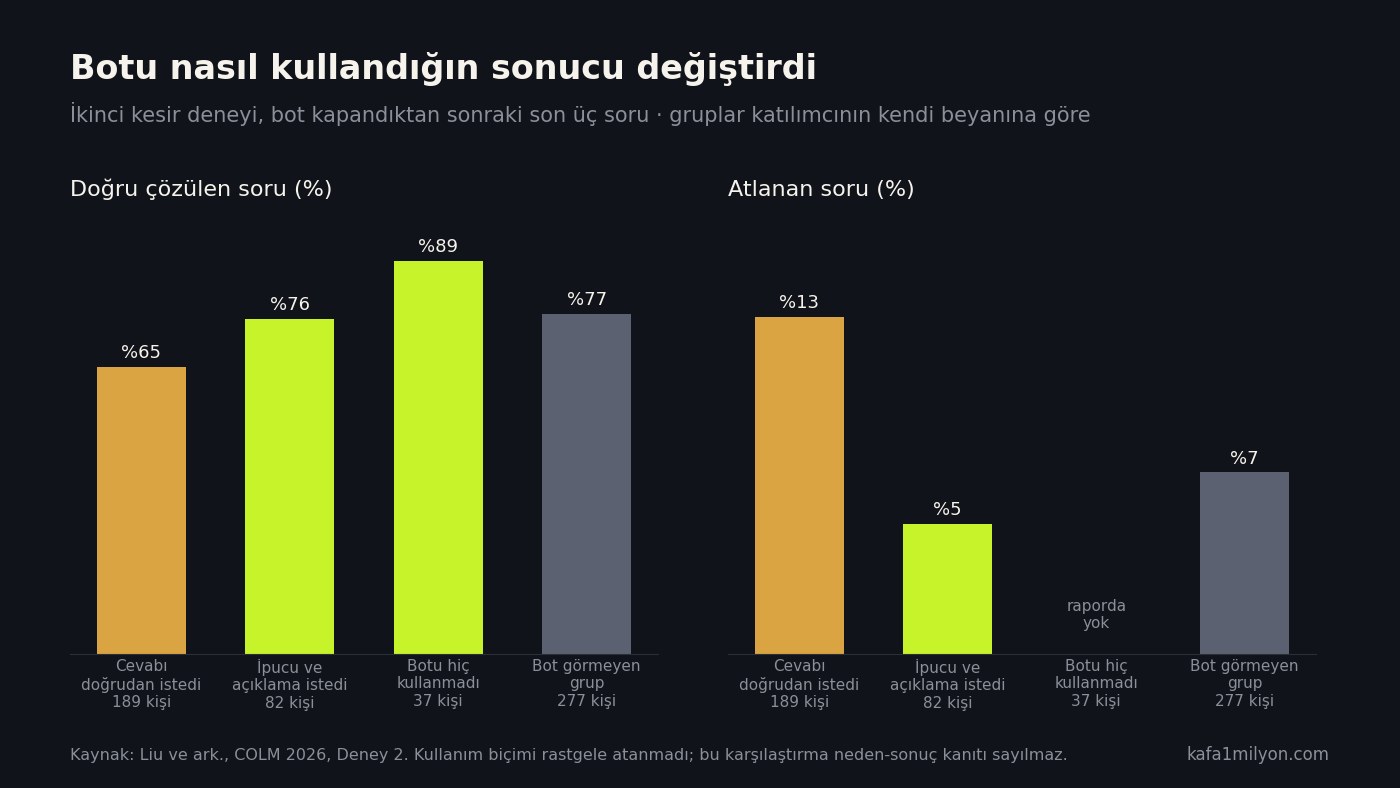
Gruplar rastgele atanmadı, kişi kendi kullanımını kendisi beyan etti. Yazarlar da bu bölümün neden-sonuç kanıtı olmadığını yazıyor. Yine de aynı ayrım başka bir deneyde de çıktı. Anthropic'ten Judy Hanwen Shen ve Alex Tamkin, 52 yazılımcıya Trio adlı yeni bir Python kütüphanesini öğretti. Yapay zekâ yardımıyla çalışanlar sonraki bilgi sınavında ortalama yüzde 50, elle yazanlar yüzde 67 aldı. Bot grubundan yüksek puan alanlar, bota yalnızca kavram soran ya da ürettiği kodun açıklamasını isteyenlerdi.3
Hesap makinesinden farkı
İnsanlar hesap makinesine, arama motoruna ve navigasyona da iş devretti. Yazarlar sohbet botunu bunlardan ayrı tutuyor, çünkü bot her soruyu çözüyor, neredeyse hiç hayır demiyor ve cevabı saniyesinde veriyor. Makale düşüşe iki olası açıklama öneriyor. Biri, bir işin ne kadar sürmesi gerektiğine dair beklentinin kayması; cevap birkaç saniyede gelmeye başlayınca yardımsız çalışmak olduğundan daha zahmetli görünüyor. Öbürü, kişinin uğraşarak neyi yapabildiğini öğrenme fırsatını kaybetmesi. İkisi de bu deneylerde doğrudan ölçülmedi, yazarların hipotezi olarak duruyor.1
Kesir seçimi de buna bağlı. Yazarlara göre kesirli işlem bir makineye bırakılabilir gibi görünse de kavramı oturmamış biri cebire geçemiyor. Benzer bir kaygı tıpta da ölçüldü. Polonya'da dört endoskopi merkezi yapay zekâ destekli kolonoskopiye geçtikten sonra, hekimlerin yardımsız yaptığı kolonoskopilerde adenom denen ve kansere dönüşebilen polipleri bulma oranı yüzde 28,4'ten yüzde 22,4'e indi. O çalışma gözleme dayanıyor, rastgele atama yok.4
Neyi henüz bilmiyoruz
Deneylerin hepsi kısa. Katılımcılar ABD'de yaşayan, para karşılığı katılan yetişkinlerdi; çocuklar ve öğrenciler ayrıca incelenmedi. Test bot kapandıktan hemen sonra 3 soruyla yapıldı, bir hafta sonra ne kaldığına bakılmadı. Bot cevabı baştan bildiği için gerçek hayattaki kullanımdan daha kolay bir kestirme sunuyordu.1
Şirketlerin çözümü öğretici modlar. OpenAI 29 Temmuz 2025'te ChatGPT'ye cevabı hemen vermek yerine soru soran ve ipucu veren bir çalışma modu ekledi. Ancak kullanıcı tek tıkla normal moda dönebiliyor, şirket öğrenciyi bu moda kilitleyen bir ayar da sunmuyor.5 Liu ve ekibi bu tür kullanıcı tarafı önlemleri yara bandına benzetiyor; onlara göre sorun, sistemlerin yalnızca o anki memnuniyete göre eğitilmesi.1 Her gün aylarca bot kullananların sebatını izleyen kontrollü bir çalışma henüz yayımlanmadı. Bugüne kadarki en uzun deney 15 dakika sürdü.
Dipnotlar ve Kaynaklar
- Liu, G., Christian, B., Dumbalska, T., Bakker, M. A. ve Dubey, R. (2026). "AI Assistance Reduces Persistence and Hurts Independent Performance". Conference on Language Modeling (COLM 2026); ilk sürüm 6 Nisan 2026. arXiv:2604.04721; proje sayfası ↩
- Pohl, J. (2026, 9 Ekim). "Study explores how AI use affects performance on math and reasoning tasks". Berkeley News, University of California, Berkeley. news.berkeley.edu ↩
- Shen, J. H. ve Tamkin, A. (2026). "How AI Impacts Skill Formation". Anthropic. arXiv:2601.20245; anthropic.com ↩
- Budzyń, K., Romańczyk, M., Kitala, D. ve ark. (2025). "Endoscopist deskilling risk after exposure to artificial intelligence in colonoscopy: a multicentre, observational study". The Lancet Gastroenterology & Hepatology, 10(10), 896–903. doi:10.1016/S2468-1253(25)00133-5 ↩
- OpenAI (2025, 29 Temmuz). "Introducing study mode". openai.com; Zeff, M. (2025, 29 Temmuz). "OpenAI launches Study Mode in ChatGPT". TechCrunch. techcrunch.com ↩
Kapak: "A student utilizing ChatGPT", MCGAMER YOUTUBE, Wikimedia Commons, CC0. Grafikler: kafa1milyon.com, veri: Liu ve ark., COLM 2026.
Kerem
İstanbul'da yaşıyor. Teknoloji yazıyor.