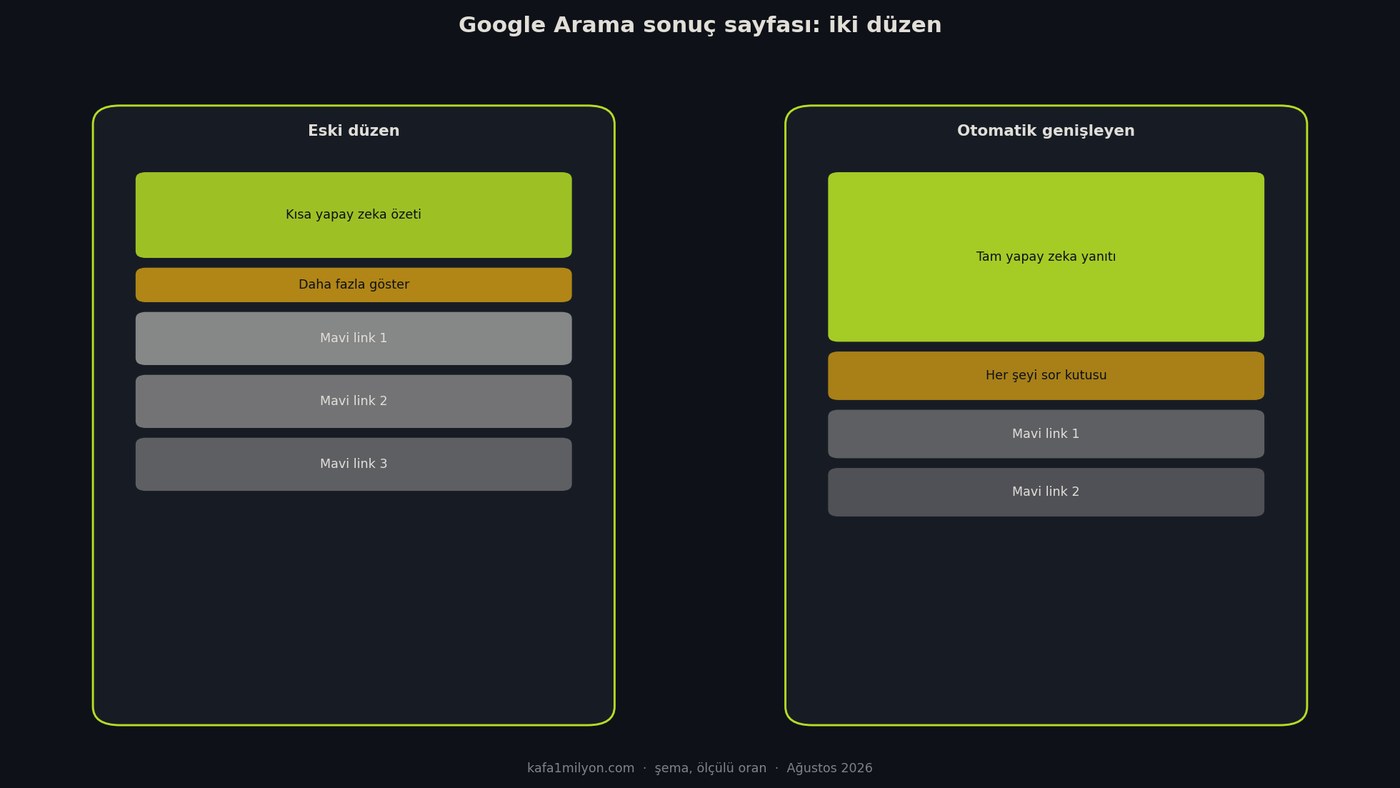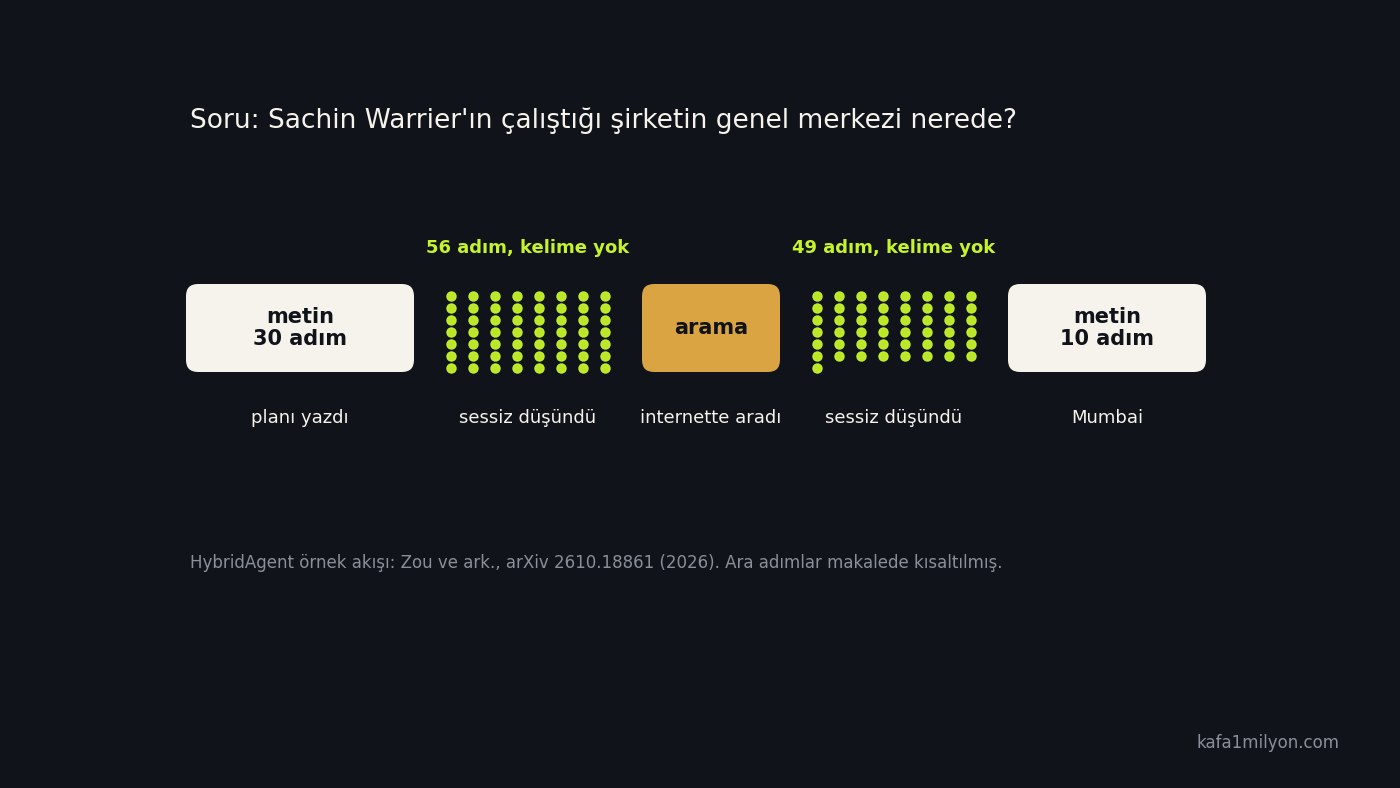
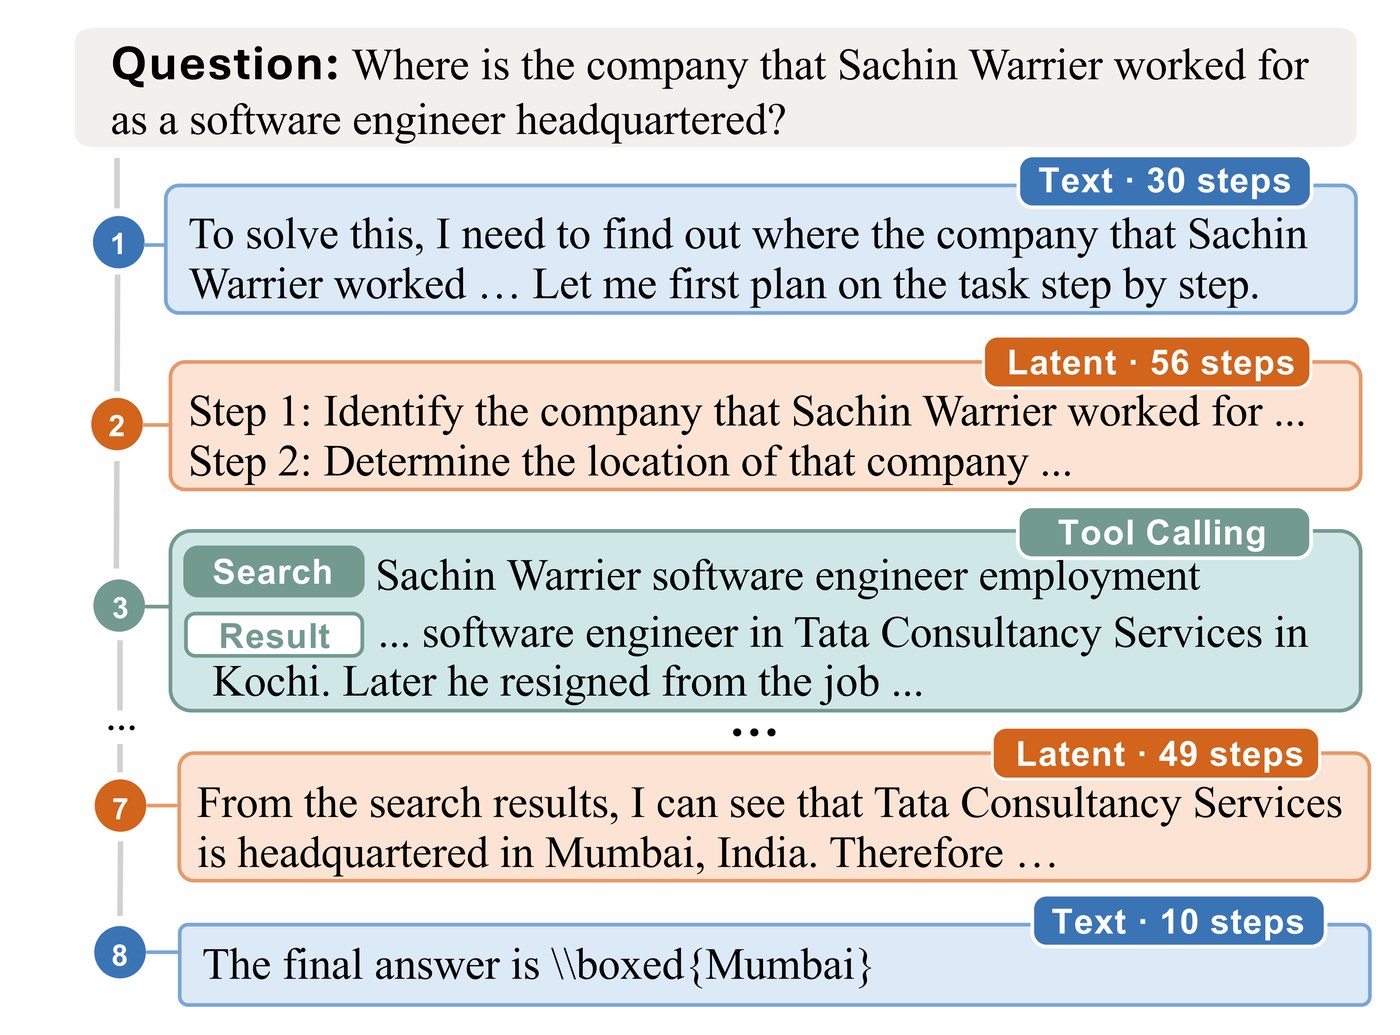
Soru makaledeki örneklerden biri: Sachin Warrier adlı yazılım mühendisinin çalıştığı şirketin genel merkezi nerede? HybridAgent adlı yapay zeka ajanı önce 30 adımda düz metinle bir plan yazdı. Sonraki 56 adımda ekrana tek kelime dökmedi, ardından arama motorunu çağırdı. Sonuç, Warrier'ın Kochi'de Tata Consultancy Services'te çalıştığını söylüyordu. Makalenin kısalttığı birkaç adımın ardından ajan 49 adım daha sessiz kaldı ve cevabı 10 adımlık bir metinle verdi: Mumbai.1
Makale 13 Ekim 2026'da arXiv'e yüklendi. Sekiz yazarı Stanford Üniversitesi, Together AI ve Illinois Üniversitesi'nden; ekibin başında Stanford'dan James Zou var. Kod da eğitilmiş modeller de herkese açık.12
- Akıl yürüten sohbet botları düşünürken neden her adımı yazıya döküyor ve bunun faturası nereye yansıyor?
- Kelimesiz düşünen önceki modeller internette arama yapmayı neden beceremiyordu?
- Araştırmacılar modelin sessiz adımlarını bozduğunda matematik doğruluğu ne kadar düştü?
- Ekranda görünmeyen düşünceyi kimin okuyabileceği güvenlik araştırmacılarını neden ilgilendiriyor?
Her adımı yazmanın bedeli
Bugünkü akıl yürüten modeller zor bir soruda cevaptan önce uzun bir iç konuşma üretir. Bu konuşma kelime parçalarından, yani token denen birimlerden oluşur ve model bir parçayı yazmadan sonrakine geçemez. OpenAI bu düşünce tokenlarını kullanıcıya göstermiyor ama çıktı tokenı olarak faturaya ekliyor; şirketin belgesine göre tek bir cevap için birkaç yüzden on binlerceye kadar düşünce tokenı harcanabiliyor.3 Uzayan düşünce, beklenen süreyi de ödenen parayı da büyütüyor.
Kelimeye dökmeden düşünme fikri yeni sayılmaz. Meta'dan Shibo Hao ve ekibi Aralık 2024'te Coconut adlı yöntemi yayımladı. Modelin son katmandaki iç durumu, yani uzun bir sayı dizisi olan vektör, kelimeye çevrilmeden doğrudan bir sonraki adıma geri veriliyordu.4 Bu vektörlerin bulunduğu matematiksel uzaya gizil alan deniyor. Gizil düşüncenin dışarıyla bağı yoktu ama. Arama motoru da Python yorumlayıcısı da metin bekliyor. Yeni makalenin ölçümünde 14 milyar parametrelik Coconut, gerçek dünyadan çok adımlı görevler soran GAIA testinde yüzde 6,8'de kaldı.1
İki kip arasında 10 milyon parametrelik köprü
Stanford ekibi araya HybridLink adını verdiği küçük bir katman koydu. Katman modelin iç durumunu kelimelerin modele girdiği uzaya tercüme ediyor, böylece model aynı akışın içinde iki kip arasında gidip gelebiliyor. 4 milyar parametrelik bir modelde köprünün yaklaşık 10 milyon parametresi var, modelin binde 2,5'i kadar.1
Model özel bir işaret ürettiğinde sessiz kipe giriyor. İç durumu en çok çıkış işaretine benzediği anda metne dönüyor. Arama yapacağı, kod çalıştıracağı ya da cevap vereceği yerde mutlaka yazıyor, çünkü araçlar yalnızca metni anlıyor. Önceki turların metni, sessiz adımları ve arama sonuçları tek bir çalışma belleğinde birlikte taşınıyor.1
Eğitim iki aşamada yapıldı. Önce 54 bin örnek akışla modele hangi adımın sessiz, hangisinin yazılı olacağı gösterildi. Ardından pekiştirmeli öğrenmeyle, yani doğru cevabı ödüllendiren deneme yanılmayla, ne zaman susup ne zaman yazacağını kendisi buldu. Ekip sessiz kipi kullanmaya ayrıca ödül koymadı. Eğitim ilerledikçe 14 milyar parametrelik model düşünmesinin daha büyük bölümünü yine de sessiz kipe kaydırdı ve araçları daha çok kullanmaya başladı. Testlerde Alibaba'nın açık Qwen3 modellerinin 4, 8 ve 14 milyar parametrelik sürümleri temel alındı.1
- 52,4
- 14 milyar parametrelik HybridAgent'ın GAIA testindeki ortalama başarısı; aynı tabloda GPT-5.6-Luna 37,9'da kaldı.Zou ve ark., arXiv 2610.18861, 2026
- %43-49
- Aynı boyuttaki metin ajanına göre dışarıya yazılan metindeki azalma.Zou ve ark., arXiv 2610.18861, 2026
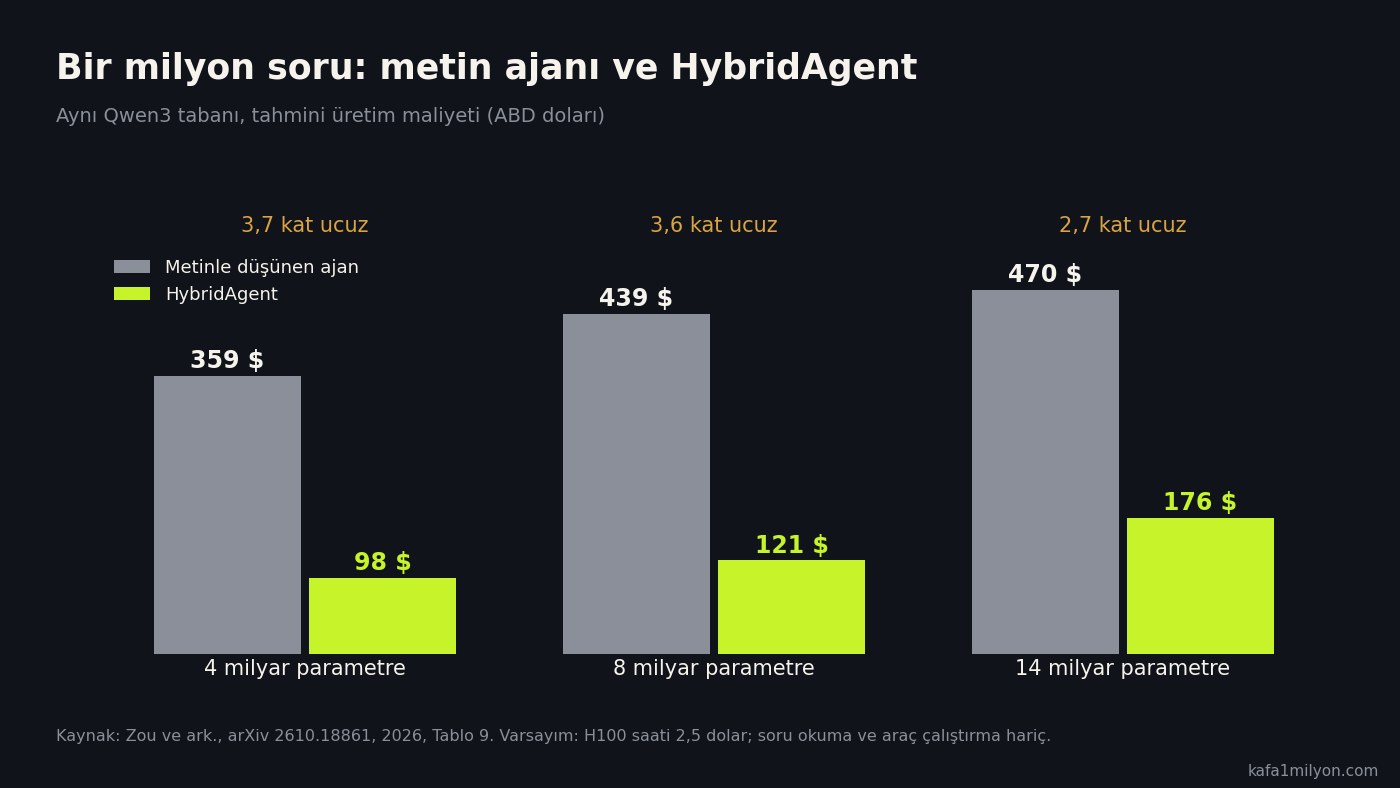
- 176 dolar
- 14 milyar parametrelik modelde bir milyon soru başına tahmini üretim maliyeti; metin ajanında 470 dolar.Zou ve ark., arXiv 2610.18861, 2026
- 41
- Düşünce zincirini okuyabilmenin kırılgan bir güvenlik imkânı olduğunu yazan 2025 bildirisinin yazar sayısı.Korbak ve ark., arXiv 2507.11473, 2025
Sessiz adımlar gerçekten iş görüyor mu
Hızlanmanın arkasında bir kestirme olup olmadığını anlamak için ekip sessiz adımları kasten bozdu ve 500 soruluk MATH500 matematik testinde doğruluğu ölçtü. 14 milyar parametrelik modelin normal doğruluğu yüzde 88,2. Sessiz kip tamamen kapatılıp model yalnızca yazarak düşünmeye zorlanınca yüzde 78,8'e indi. Sessiz adımların yerine başka bir sorunun sessiz adımları konunca yüzde 48,6'ya, rastgele kelime vektörleri konunca yüzde 44,6'ya düştü.1
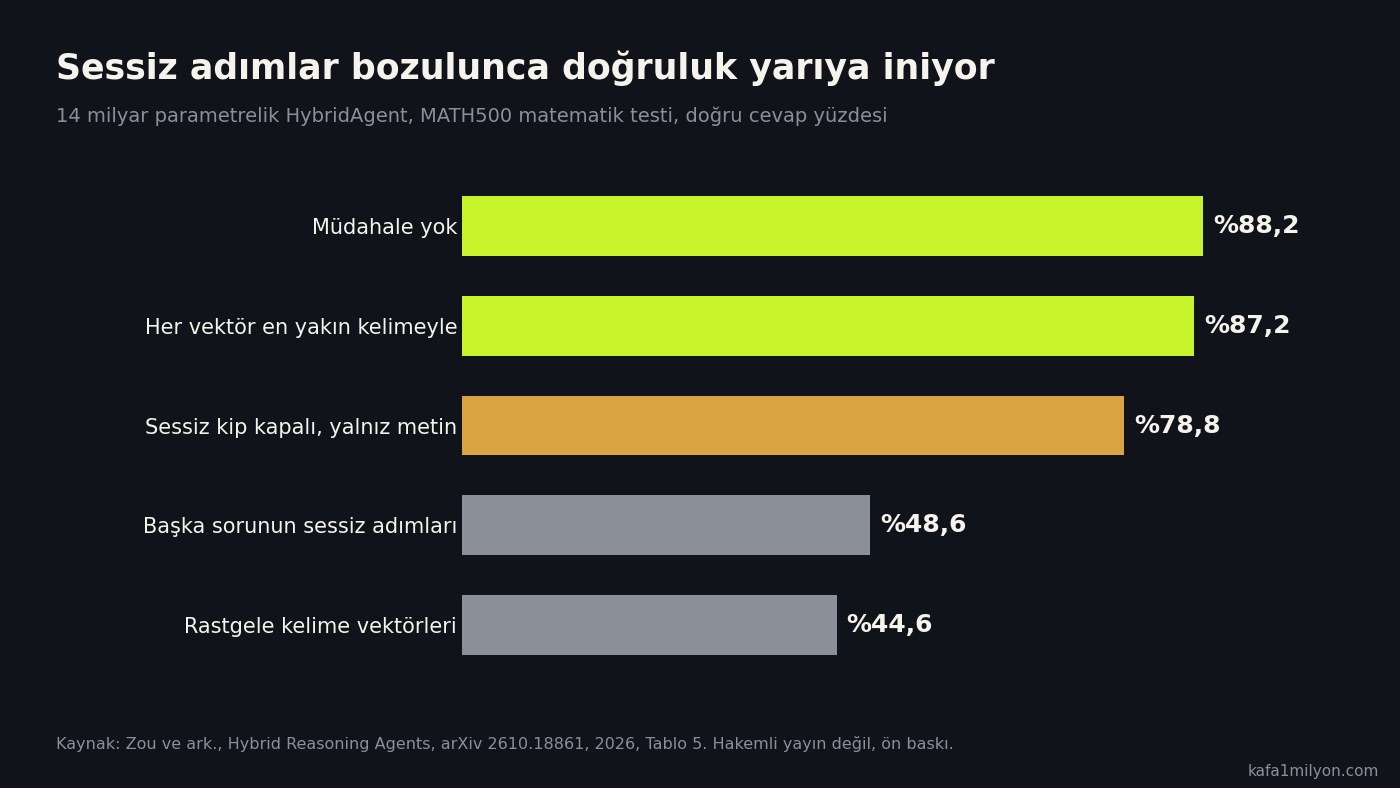
Her sessiz vektör kendisine en yakın kelimeyle değiştirildiğinde doğruluk yalnızca bir puan düşüp yüzde 87,2'de kaldı. Demek ki sessiz vektörler kelimelere yakın duruyor. Şekildeki taslak cümleler de bu yakınlıktan yararlanılarak okunuyor.1
Bu kazanç faturaya da yansıyor. Ekibin hesabına göre 14 milyar parametrelik metin ajanı bir milyon soruyu yaklaşık 470 dolara cevaplarken HybridAgent aynı işi 176 dolara yapıyor; 4 milyar parametrede fark 3,7 kata çıkıyor. Hesap bir H100 grafik işlemcinin saatini 2,5 dolar sayıyor. Soru metnini okuma ve araçları çalıştırma maliyeti içinde yok.1
Görünmeyen düşünceyi kim okuyacak
Temmuz 2025'te aralarında Yoshua Bengio'nun ve OpenAI, Google DeepMind, Anthropic araştırmacılarının da bulunduğu 41 kişilik bir grup ortak bir uyarı yayımladı. Modellerin düşüncesini insan dilinde yazması, hatalı ya da zararlı bir planı daha uygulanmadan görmeyi sağlıyordu. Yazarlar bu imkânın kırılgan olduğunu, modeli insan dilinden uzaklaştıran yöntemlerle kaybolabileceğini yazdı.5
HybridAgent'ın ekibi buna ölçümle karşılık veriyor. 560 matematik sorusunda dışarıdan bakan bir denetçi model, cevabın doğru çıkıp çıkmayacağını HybridAgent'ın kısalmış metninden de metin ajanının uzun metninden de neredeyse aynı başarıyla tahmin etti. Başarısız denemelerin yüzde 98'inden fazlasında ilk hatanın yeri de görünür metinden bulundu.1
Sessiz adımları okuyan köprü ise modeli işleten şirketin elinde duruyor. Makalenin tartışma bölümü bunu bir avantaj sayıyor: sızdırılacak bir düşünce metni ortada yok, şirket gizli kısmı da denetleyebiliyor, kullanıcıya araç çağrıları, önemli kararlar ve cevap gösteriliyor.1 Senin göreceğin kısım 14 milyar parametrelik modelde soru başına ortalama 497 metin tokenından 284'e iniyor. Geride kalan ortalama 183 sessiz adımı okumak sağlayıcıya kalıyor.
Henüz bilinmeyenler
Makale hakem değerlendirmesinden geçmemiş bir ön baskı ve bütün karşılaştırmaları yazarlar kendisi koştu. Denenen en büyük model 14 milyar parametre; bugün sohbet uygulamalarının arkasındaki modeller bunun çok üstünde ve yöntemin o ölçekte aynı kazancı verip vermediği bilinmiyor. Yaygın model sunucu yazılımları iki kipli üretimi desteklemediği için ekip kendi altyapısını yazmak zorunda kaldı.1
Kod GitHub'da, 8 milyar parametrelik ajan modeli Hugging Face'te açık.2 İddiaların ilk bağımsız sınavı, aynı 11 testi kendi grafik işlemcilerinde koşacak başka ekiplerden gelecek.
Dipnotlar ve Kaynaklar
- Zou, J., Qi, Y., Chen, S., Bianchi, F., Zhu, S., Lu, P., He, J. ve Zou, J. (2026). "Hybrid Reasoning Agents". arXiv:2610.18861 (ön baskı, hakem değerlendirmesinden geçmedi). doi:10.48550/arXiv.2610.18861 ↩
- Together AI (2026). HybridAgent kod deposu ve HybridAgent-8B-Agentic modeli. github.com/togethercomputer/HybridAgent; huggingface.co/togethercomputer/HybridAgent-8B-Agentic ↩
- OpenAI (2026). "Reasoning models", geliştirici belgeleri. developers.openai.com/api/docs/guides/reasoning ↩
- Hao, S., Sukhbaatar, S., Su, D., Li, X., Hu, Z., Weston, J. ve Tian, Y. (2024). "Training Large Language Models to Reason in a Continuous Latent Space". arXiv:2412.06769. arxiv.org/abs/2412.06769 ↩
- Korbak, T., Balesni, M., Barnes, E., Bengio, Y. ve ark. (2025). "Chain of Thought Monitorability: A New and Fragile Opportunity for AI Safety". arXiv:2507.11473. arxiv.org/abs/2507.11473 ↩
Kapak ve grafikler: kafa1milyon.com, veri: Zou ve ark. 2026. Örnek akış şekli: Zou ve ark., arXiv 2610.18861, CC BY 4.0. Rakamlar hakem değerlendirmesinden geçmemiş bir ön baskıdan alındı.
Kerem
İstanbul'da yaşıyor. Teknoloji yazıyor.